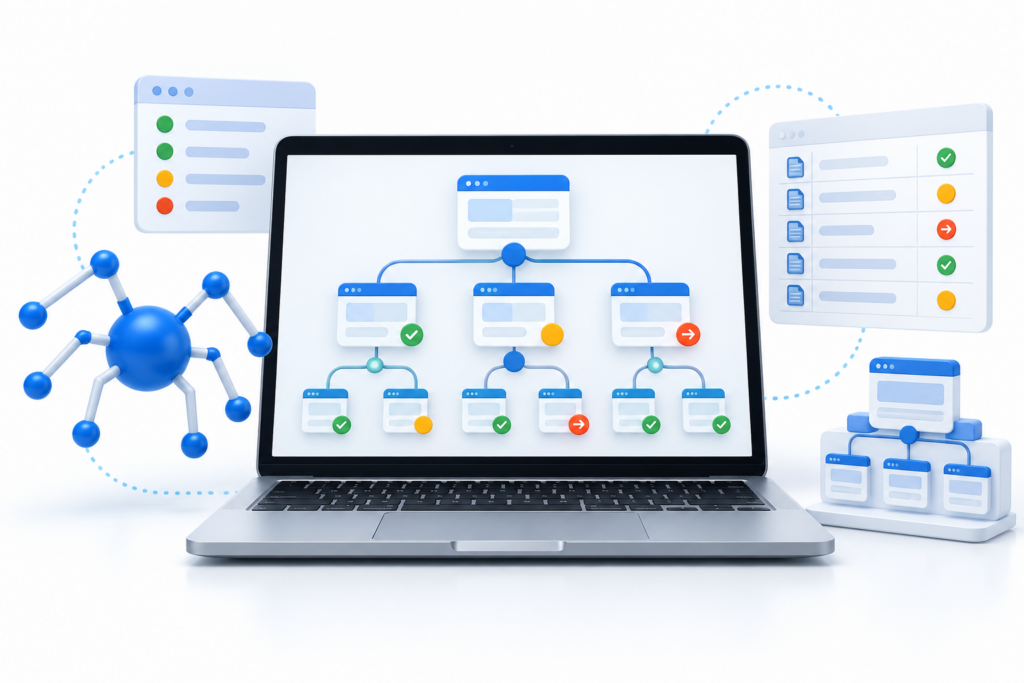
O Screaming Frog SEO Spider é um crawler para examinar URLs e elementos técnicos de um site em escala. Ele ajuda a localizar links quebrados, redirecionamentos, títulos ausentes, canonicals e outras situações que merecem investigação. O relatório é um retrato do rastreamento feito com a configuração escolhida; não é uma decisão do Google sobre rastreamento, indexação ou posicionamento.
Este guia organiza um fluxo de trabalho para iniciar, limitar e interpretar uma auditoria. Os nomes de menus e recursos mudam entre versões. Consulte a documentação oficial quando precisar confirmar uma opção, um requisito de instalação ou uma restrição de licença.
Antes de iniciar o rastreamento
Confirme o escopo e a autorização. Para um site público da própria empresa, escolha o domínio ou subdomínio que deseja analisar. Em ambientes de teste, áreas privadas, intranets ou sites de clientes, faça o rastreamento somente com acesso e autorização adequados. Crawls grandes ou paralelos podem consumir recursos do servidor; combine limites, velocidade e horário com a equipe técnica.
- Defina a pergunta da auditoria: links quebrados, páginas sem título, canonicals, sitemaps, JavaScript ou uma migração.
- Escolha uma URL inicial e decida se subdomínios e caminhos externos entram no escopo.
- Ajuste limites de URLs, profundidade, parâmetros, pastas e respostas quando o site for grande.
- Decida se o crawler lerá o HTML bruto ou renderizará JavaScript; use a modalidade adequada ao que quer verificar.
- Guarde o perfil de configuração e anote data, escopo e limites para tornar comparações posteriores interpretáveis.
Um fluxo simples de auditoria
1. Abra o SEO Spider e insira a URL inicial no modo de rastreamento apropriado. 2. Revise o escopo e os limites antes de começar. 3. Aguarde a conclusão e verifique se houve bloqueios, respostas temporárias ou limites atingidos. 4. Explore filtros por tema em vez de exportar tudo sem uma pergunta definida. 5. Exporte apenas as tabelas necessárias e confirme amostras no navegador, no código-fonte e, quando pertinente, em Search Console ou analytics.
Na versão gratuita, a documentação oficial consultada informa um limite de 500 URLs por rastreamento e restrições em salvar crawls, configurações e recursos avançados. Esses limites e as condições de licença podem mudar; verifique a página oficial antes de escolher uma versão ou orçamento.
Relatórios que ajudam a encontrar problemas
Códigos de resposta: agrupe respostas 4xx, 5xx, redirecionamentos e URLs sem resposta. Confirme se a URL deve continuar ativa e se o destino final atende à mesma necessidade antes de corrigir em lote.
Títulos e meta descriptions: encontre campos ausentes, duplicados, muito longos ou potencialmente pouco claros. A ferramenta aponta características técnicas, não decide sozinha qual texto é mais útil para a pessoa que pesquisa.
Canonicals, diretivas e sitemap: compare URLs descobertas, canonicals e endereços declarados nos sitemaps. Um endereço listado no XML não ganha indexação por isso; investigue se a página pode ser rastreada e se a canonical e a resposta são coerentes.
Links internos: use dados de inlinks e profundidade para localizar destinos importantes com poucos caminhos de navegação, links quebrados e cadeias de redirecionamento. O crawler só descobre o que o escopo permite e os links que consegue interpretar.
JavaScript e conteúdo renderizado: comparar HTML bruto e renderizado pode indicar diferenças de conteúdo ou links. Uma captura do crawler não é equivalente a todos os sistemas, condições e recursos usados pelo Google; valide os casos importantes com as ferramentas de busca e com testes reais.
Como transformar achados em prioridades
Agrupe ocorrências por tipo de página e impacto. Uma falha em uma categoria principal pode afetar mais jornadas do que um campo ausente em uma página antiga sem tráfego. Registre URL de exemplo, quantidade de casos, hipótese de causa, responsável, correção proposta e critério de validação.
Não aplique correções automáticas a todos os URLs sem revisar as exceções. Um redirecionamento pode ser intencional, títulos diferentes podem ser necessários para variantes distintas, e uma página bloqueada pode pertencer a um ambiente que não deveria entrar no índice. Corrija primeiro um grupo pequeno, verifique a resposta e depois amplie.
O que o Screaming Frog não comprova
Um aviso é uma pista para investigar, não necessariamente um erro. O crawler não informa sozinho se o Google indexou a URL, qual consulta trouxe uma visita ou se uma mudança causou aumento de receita. Combine o rastreamento com Search Console, logs, analytics, testes no site e conhecimento de negócio.
A ferramenta também não substitui priorização, revisão editorial nem avaliação de acessibilidade e usabilidade. Mantenha a auditoria ligada a uma tarefa: reduzir erro de rastreamento, proteger URLs importantes, corrigir uma migração ou melhorar a descoberta de páginas com valor para o público.
Exemplo de aplicação
Uma equipe quer auditar páginas com status, canonical e links quebrados. Configura o Spider com limite de taxa, escopo do domínio e renderização adequada, executa uma amostra e compara resultados com inspeção manual. Agrupa erros por template e prioriza os que afetam URLs importantes. O relatório vira uma lista de tarefas verificáveis, não uma ordem para corrigir todo aviso automaticamente.
Checklist de revisão final
Antes de publicar ou atualizar o artigo, confirme estes pontos:
- A intenção da página e o público estão definidos e refletem uma necessidade real.
- Afirmações, números, condições e exemplos foram validados com fontes ou responsáveis competentes.
- Título, descrição, URL, links e imagem representam o conteúdo publicado com clareza.
- Leitura, navegação e ações principais funcionam em dispositivos móveis e com teclado.
- Há uma pessoa responsável e uma data de revisão para manter o artigo atualizado.
Perguntas frequentes
O Screaming Frog é gratuito? Há uma versão gratuita com limites. A documentação atual informa um limite de 500 URLs por rastreamento e restrições em recursos e salvamento; consulte a página de preços para a situação vigente.
O crawler simula exatamente o Googlebot? Não. É um rastreador configurável que pode renderizar JavaScript e usar opções próprias. Mesmo com configurações semelhantes, seus relatórios não são uma réplica dos sistemas de rastreamento e indexação do Google.
Encontrar uma URL no rastreamento significa que ela está indexada? Não. Descoberta pelo crawler é diferente de rastreamento pelo Google e de inclusão no índice. Confirme o estado no Search Console e avalie a URL e suas diretivas.
Leia também: SEO Spider e crawlers na auditoria técnica
Leia também: análise de logs para SEO
Guia oficial do Screaming Frog SEO Spider