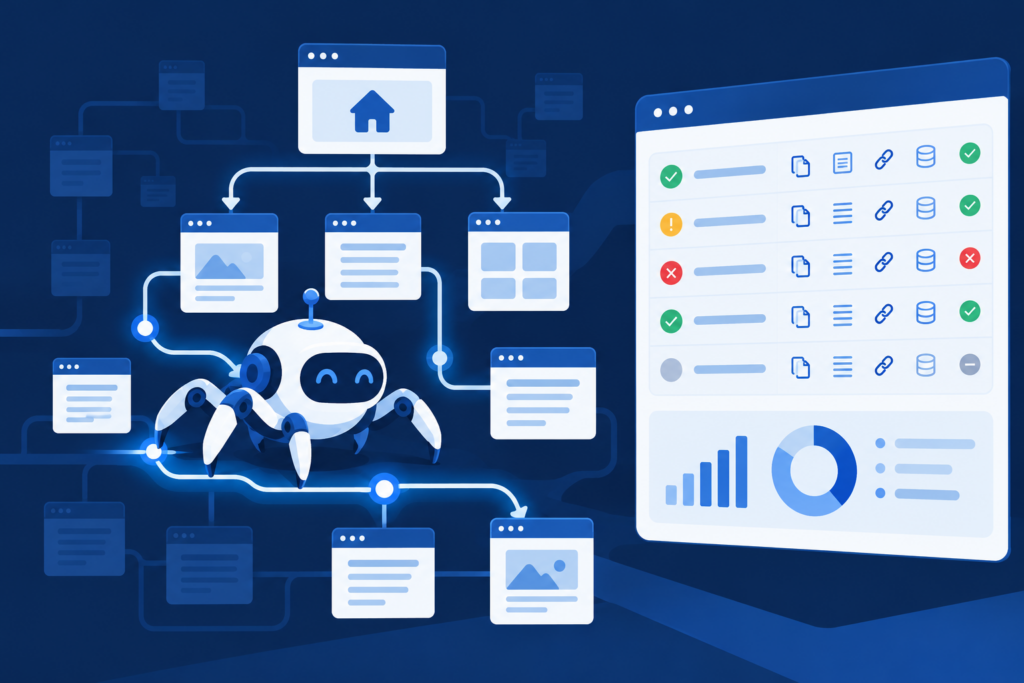
Um SEO Spider, ou crawler de auditoria, percorre URLs e registra dados como status HTTP, títulos, canonicals, diretivas e links. Ele ajuda a encontrar padrões em muitas páginas, mas observa o site a partir de um escopo e uma configuração definidos. O resultado não é uma cópia do Google nem uma lista automática de problemas que precisam ser corrigidos.
Use a ferramenta para responder a uma pergunta concreta: existem links quebrados em páginas prioritárias? Canonicals apontam para outra versão? Títulos estão ausentes em determinado modelo? Uma auditoria começa pelo problema e pelas URLs que precisam ser examinadas.
O que um crawler SEO encontra e o que pode deixar de fora
O modo tradicional começa em uma URL e segue links que a ferramenta reconhece dentro do escopo. Uma URL sem links pode ficar fora do rastreamento. Algumas ferramentas também aceitam listas, sitemaps, analytics e Search Console como fontes complementares; o que é coletado depende da integração e da configuração.
Um crawler pode executar JavaScript para observar o HTML renderizado, mas essa opção consome mais recursos e pode ter limites de navegador, tempo e scripts. Teste primeiro um grupo representativo. Conteúdo carregado após interação, login, personalização ou consentimento pode continuar diferente do que a ferramenta consegue observar.
Rastreamento, indexação e classificação são processos diferentes. O crawler descreve uma visita simulada da ferramenta; o Search Console e os sistemas do Google mostram outros aspectos. Uma página sem erro no crawler pode não ser indexada, e um alerta da ferramenta pode não afetar visitantes ou resultados.
Guia oficial do Google sobre Googlebot e rastreadores de Pesquisa
Defina escopo e limites antes de iniciar
Registre domínio, protocolo, subdomínios, pastas, tipos de página e período. Comece com uma amostra pequena ou um diretório prioritário. Em lojas e sites com parâmetros, filtros e sessões, defina limites de URLs, profundidade e padrões a excluir para evitar que um espaço infinito de combinações consuma a auditoria.
Confirme autorização do responsável pelo site, carga aceitável para o servidor e regras de robots que a ferramenta respeitará. Em homologação, áreas privadas e ambientes de cliente, siga as instruções de acesso e a política de dados da empresa. Não aumente velocidade ou ignore bloqueios sem validação técnica.
Configure as fontes de URLs
- Crawl de links: inicia na página escolhida e segue links internos reconhecidos.
- Sitemaps: amplia a amostra para URLs declaradas pelo site, inclusive páginas que podem não receber links suficientes.
- Lista importada: verifica uma seleção de URLs do Search Console, analytics, catálogo ou relatório de conversões.
- Logs: compara endereços visitados por crawlers reais com o conjunto rastreado pela ferramenta.
- Subdomínios: habilite atravessamento entre hosts somente quando o escopo da auditoria incluir esses hosts.
Escolha renderização e regras de rastreamento
Faça uma primeira passagem em HTML e compare algumas páginas em renderização JavaScript quando o site depende de scripts para mostrar conteúdo ou links. Observe diferenças de texto, links, status, canonical e diretivas. Não conclua que toda página precisa ser rastreada em JavaScript apenas porque usa uma biblioteca de front-end.
Confira configuração de robots, user-agent, cookies, autenticação, limites e exclusões. Robots.txt orienta crawlers cooperativos sobre o que rastrear, mas não protege conteúdo confidencial nem substitui controle de acesso. Registre mudanças na configuração para que rastreamentos futuros sejam comparáveis.
Revise os relatórios que respondem à pergunta
- Status e redirecionamentos: identifique erros, destinos inesperados, cadeias e páginas prioritárias fora de 200.
- Indexabilidade e canonical: compare status, diretivas, canonical escolhida e URLs que apontam para versões divergentes.
- Títulos, descrições e headings: encontre ausências, duplicações ou padrões por modelo; valide se a diferença tem impacto editorial.
- Links internos e profundidade: procure páginas importantes sem caminhos úteis, links quebrados e dependência excessiva de navegação não textual.
- Conteúdo e duplicações: compare modelos e páginas semelhantes antes de decidir atualizar, consolidar ou manter.
- Imagens e recursos: confira erros, textos alternativos quando aplicáveis e arquivos necessários à experiência da página.
Priorize achados com contexto
Para cada achado, guarde URL, evidência, quantidade de páginas, modelo afetado, risco para usuário, impacto comercial, confiança da hipótese e responsável. Um título duplicado em páginas parecidas pode ser menos urgente que um formulário quebrado ou uma canonical incorreta em centenas de produtos.
Use filtros de ferramenta para encontrar casos, não para decidir prioridade sem revisão. Abra amostras, compare o HTML recebido e a página renderizada, confirme as diretivas e valide o comportamento no navegador. Depois da correção, rastreie novamente as mesmas URLs e registre a diferença.
Como escolher uma ferramenta de rastreamento
Compare tamanho máximo do crawl, renderização JavaScript, fontes de URLs, integrações, exportação, agendamento, colaboração e tratamento de dados. Ferramentas instaladas localmente podem servir a auditorias pontuais; serviços em nuvem e plataformas corporativas podem atender rastreamentos distribuídos, históricos e grandes propriedades. Recursos, limites e preços mudam; confira a documentação atual do fornecedor.
Screaming Frog SEO Spider e Sitebulb são exemplos de crawlers instaláveis; plataformas como Lumar e Oncrawl atendem diferentes operações de auditoria em escala. A escolha depende do tamanho do site, dados disponíveis, equipe, necessidade de renderização e rotina de trabalho — não de uma lista universal de “melhor ferramenta”.
Guia de início rápido e modos de crawl do Screaming Frog SEO Spider
Para sites grandes, combine crawler, Search Console e logs. O Google observa que crawl budget merece atenção em propriedades muito grandes, que mudam com frequência ou apresentam evidência concreta de URLs importantes não rastreadas; a maioria dos sites pequenos não precisa tentar aumentar o número de requisições.
Documentação do Google sobre crawl budget e sites grandes
Exemplo de aplicação
Uma migração está próxima e a equipe precisa encontrar URLs antigas sem redirecionamento. Configura o crawler para partir de sitemap e links internos, define quais subdomínios entram no escopo e limita a taxa de requisições para não sobrecarregar o servidor. Depois compara a lista com a arquitetura nova e valida manualmente páginas críticas. O rastreamento revela padrões, mas não equivale ao índice do buscador.
Checklist de revisão final
Antes de publicar ou atualizar o artigo, confirme estes pontos:
- A intenção da página e o público estão definidos e refletem uma necessidade real.
- Afirmações, números, condições e exemplos foram validados com fontes ou responsáveis competentes.
- Título, descrição, URL, links e imagem representam o conteúdo publicado com clareza.
- Leitura, navegação e ações principais funcionam em dispositivos móveis e com teclado.
- Há uma pessoa responsável e uma data de revisão para manter o artigo atualizado.
Perguntas frequentes
Um SEO Spider mostra todas as páginas do site? Não necessariamente. Um crawl de links encontra URLs alcançáveis pelas fontes e regras configuradas. Páginas órfãs, protegidas, sem links ou fora do escopo podem ficar de fora. Combine outras fontes e declare os limites da amostra.
Um crawler simula exatamente o Googlebot? Não. Ele pode usar um user-agent ou renderização semelhantes, mas tem infraestrutura, limites, execução e finalidade próprios. Use Search Console e documentação do Google para verificar o comportamento da Pesquisa quando isso for importante.
Devo rastrear todas as URLs do site em JavaScript? Não. Teste modelos representativos e compare o resultado com HTML simples. A renderização deve ser usada quando responde a uma questão, respeitando capacidade do servidor e limites de execução.
Todo alerta do crawler precisa ser corrigido? Não. Confirme a causa, o número de páginas afetadas, a intenção e o efeito sobre acesso, compreensão ou busca antes de priorizar. Ferramentas encontram padrões; a equipe decide o que importa.
Um crawler é mais útil quando a pergunta, o escopo e os critérios estão claros. Combine dados técnicos com contexto de página, usuário e negócio; valide uma amostra e rastreie novamente após a implementação para confirmar o que mudou.