Exemplo de aplicação
RAG é a sigla de retrieval-augmented generation, ou geração aumentada por recuperação. A arquitetura recupera informações de uma fonte externa e as inclui no contexto enviado a um modelo generativo. Assim, uma aplicação pode responder sobre documentos de uma empresa sem depender apenas do conhecimento incorporado aos parâmetros do modelo.
RAG não é um modelo específico nem sinônimo de qualquer busca com inteligência artificial. O termo ganhou força com um trabalho de pesquisa de 2020 que combinou memória paramétrica de um modelo pré-treinado com uma memória não paramétrica pesquisável. Implementações atuais podem variar nos índices, modelos de embedding, filtros, reranqueamento e formas de citar as fontes.
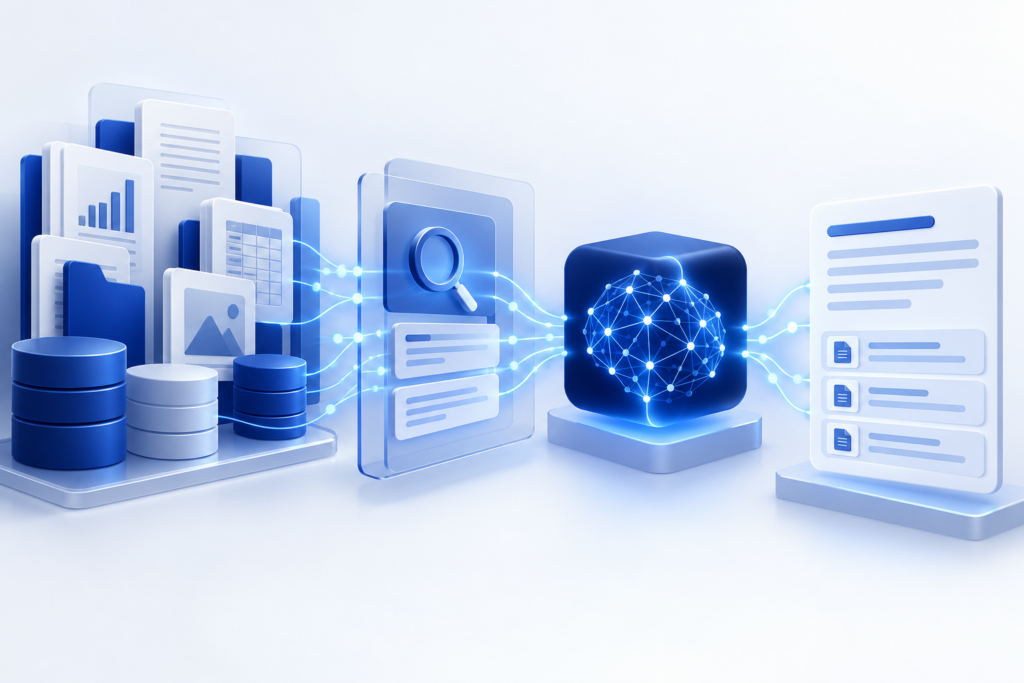
Quais são as etapas de um fluxo RAG
- Preparar fontes: reunir documentos autorizados, remover versões obsoletas e associar metadados como tema, data, unidade e permissão.
- Dividir e indexar: separar o material em trechos úteis, representar os trechos em uma estrutura pesquisável e preservar sua origem.
- Interpretar a pergunta: identificar a necessidade, o contexto da conversa e eventuais filtros de acesso ou período.
- Recuperar: localizar trechos lexicalmente ou semanticamente relacionados à consulta.
- Ranquear e montar contexto: priorizar evidências pertinentes, evitar duplicatas e limitar o que será enviado ao modelo.
- Gerar e revisar: redigir uma resposta com base no contexto, incluir referências quando o sistema suporta isso e encaminhar dúvidas sem evidência.
A recuperação semântica usa representações vetoriais para encontrar trechos relacionados por significado, mesmo quando as palavras não coincidem exatamente. Isso pode complementar pesquisa por termos. Nenhuma dessas técnicas garante que o trecho correto seja encontrado: qualidade da busca, filtros, linguagem da pergunta e organização da base continuam decisivos.
RAG, fine-tuning e grounding: diferenças
No RAG, a aplicação procura material em uma fonte e fornece trechos ao modelo no momento da resposta. Fine-tuning ajusta os parâmetros de um modelo com exemplos ou dados para mudar aspectos de seu comportamento; não é o mesmo que consultar um repositório atualizado a cada pergunta. Grounding é um conceito mais amplo de ancorar uma resposta em informações ou evidências, enquanto RAG é uma maneira de fazer isso por recuperação.
Uma empresa pode combinar essas abordagens. Por exemplo, pode ajustar instruções e estilo de resposta, recuperar políticas atualizadas e exigir que cada resposta indique o documento de origem. A arquitetura deve ser escolhida pelo problema e pelas evidências de qualidade, não porque a sigla está em alta.
Quando RAG pode ajudar
Uma base RAG pode ser útil quando muitas perguntas dependem de documentos empresariais que mudam, como manuais de produto, políticas internas, catálogos ou procedimentos de atendimento. Em vez de reproduzir todos esses textos na instrução de cada consulta, o sistema busca trechos pertinentes e apresenta ao modelo apenas o contexto necessário. Isso pode facilitar atualização e auditoria, desde que fontes, permissões e revisões estejam bem administradas.
Considere uma distribuidora com fichas técnicas e regras por região. Uma pergunta sobre compatibilidade pode exigir a versão vigente do produto, o mercado atendido e uma restrição comercial. Um RAG bem desenhado pode recuperar os documentos correspondentes; ainda assim, precisa reconhecer quando faltam dados, citar a fonte correta e encaminhar casos ambíguos a uma pessoa.
Limites e riscos que não desaparecem
- Recuperação errada: o sistema pode encontrar conteúdo parecido, mas inadequado à pergunta.
- Fonte desatualizada: indexar um documento antigo pode gerar uma resposta convincente e incorreta.
- Permissões: filtros precisam impedir que uma pessoa consulte registros que não poderia acessar.
- Trechos mal divididos: uma definição sem sua condição, tabela ou ressalva pode perder sentido.
- Resposta extrapolada: o modelo pode acrescentar conclusões que não estão no contexto recuperado.
- Citações frágeis: um link para o arquivo não prova que cada frase da resposta é apoiada pela fonte.
- Custo e latência: indexação, busca, chamadas de modelo e monitoramento fazem parte da operação.
Como avaliar uma implementação
Meça a recuperação e a resposta separadamente. Para recuperação, verifique se os trechos relevantes aparecem entre os resultados, se o sistema respeita filtros e se as fontes estão atualizadas. Para a resposta, avalie precisão, completude, clareza, atribuição e comportamento quando não há evidência suficiente. Use perguntas reais, incluindo exceções, consultas sem resposta e formulações variadas.
Mantenha uma pessoa responsável pela base e estabeleça processo para incluir, substituir e remover documentos. Registre a origem de cada trecho, monitore respostas problemáticas e proteja dados sensíveis. Uma prova de conceito deve ter critérios de aceitação definidos antes de ser comparada com o fluxo atual.
RAG melhora SEO ou faz uma marca aparecer em buscas com IA?
Não por si só. Uma aplicação RAG interna que consulta documentos privados não muda automaticamente o rastreamento ou a visibilidade pública do site. Uma ferramenta de busca na web pode usar recuperação para montar uma resposta, mas sua seleção de fontes depende dos sistemas de descoberta e dos critérios próprios do produto. Não há garantia de que criar uma arquitetura RAG para a empresa aumente citações externas.
Para o trabalho editorial e de SEO, a lição é outra: conteúdo claro, bem estruturado, atualizado e apoiado em fontes verificáveis é mais fácil de interpretar por pessoas e sistemas. Isso não exige produzir conteúdo para uma implementação específica de RAG nem repetir termos técnicos sem utilidade para quem pesquisa.
Checklist de revisão final
Antes de publicar ou atualizar o artigo, confirme estes pontos:
- A intenção da página e o público estão definidos e refletem uma necessidade real.
- Afirmações, números, condições e exemplos foram validados com fontes ou responsáveis competentes.
- Título, descrição, URL, links e imagem representam o conteúdo publicado com clareza.
- Leitura, navegação e ações principais funcionam em dispositivos móveis e com teclado.
- Há uma pessoa responsável e uma data de revisão para manter o artigo atualizado.
Perguntas frequentes
RAG elimina alucinações? Não. Pode fornecer evidências externas e ajudar a limitar respostas, mas ainda há falhas na busca, no contexto, na interpretação ou na geração. Avaliação e revisão continuam importantes.
RAG atualiza automaticamente o conhecimento da IA? Não. A base precisa receber documentos novos e ser indexada. A resposta só pode usar a informação que foi recuperada e incluída no contexto naquela execução.
RAG sempre usa busca vetorial? Não. Muitas arquiteturas usam embeddings e busca semântica, mas também podem combinar pesquisa lexical, filtros, reranqueadores ou outros métodos. O desenho depende dos dados e das consultas.
Referências para aprofundar
Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — artigo de pesquisa
Retrieval — documentação da API OpenAI
Introduction to Large Language Models — Google for Developers
Leia também na AtivaSEO
Chunking de conteúdo: quando dividir ajuda e quando vira truque
Busca com IA do Google: o que uma empresa pode preparar
Dados estruturados e busca com IA: para que servem de verdade