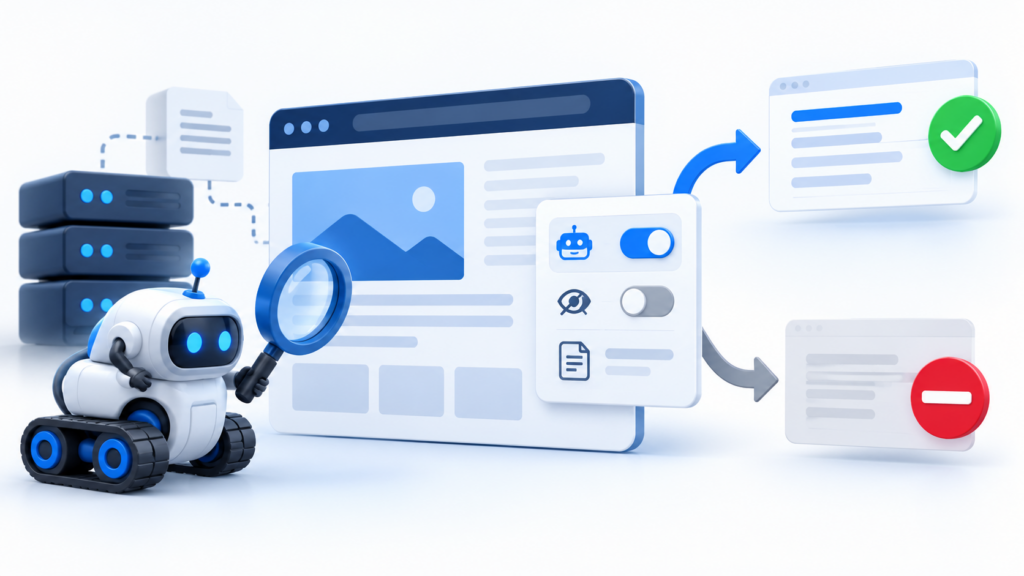
A meta robots é uma instrução que pode orientar mecanismos de busca sobre como tratar uma página e o que exibir nos resultados. A configuração parece pequena, mas um noindex aplicado por engano pode tirar uma página dos resultados quando o Google rastrear e processar a diretiva.
Antes de alterar essa configuração, identifique o objetivo: impedir a indexação, limitar um trecho exibido como snippet ou orientar o tratamento de links. Não use a mesma solução para todos esses casos.
O que é a meta robots
Em páginas HTML, a diretiva pode ser informada no elemento head por meio de uma tag meta. O valor noindex orienta o Google a não exibir a página nos resultados depois que o rastreador consegue acessá-la e ler a instrução. Sem uma regra restritiva, a indexação continua sendo uma decisão do mecanismo de busca; indicar index não garante que uma URL será indexada.
A regra pode ser direcionada aos mecanismos em geral, com name="robots", ou a um rastreador específico, como name="googlebot". Use a configuração global quando a intenção for comum a todos os mecanismos compatíveis e uma regra específica apenas quando houver motivo claro.
Meta robots e robots.txt fazem trabalhos diferentes
O robots.txt controla se um rastreador pode solicitar uma URL. A meta robots e o cabeçalho X-Robots-Tag são lidos quando a URL pode ser rastreada; eles orientam a indexação e a apresentação do resultado. Portanto, se uma página precisa ser removida com noindex, não bloqueie o rastreamento dela antes que o Google consiga ver essa regra.
Exemplo de aplicação
Se o rastreador for impedido pelo robots.txt, ele pode não encontrar o noindex. Uma URL bloqueada ainda pode aparecer nos resultados sem descrição completa, por exemplo se houver links para ela. Para controlar a indexação, permita o rastreamento e use a diretiva apropriada; bloqueie rastreamento apenas quando essa for a finalidade.
Bloquear a indexação com noindex — Google Search Central
Diretivas mais comuns e para que servem
- noindex: pede que a página ou o recurso não apareça nos resultados de busca compatíveis, depois que o rastreador lê a instrução.
- nofollow: orienta o tratamento dos links daquela página; não é uma regra para retirar a página do índice.
- nosnippet: restringe a exibição de snippet de texto nos resultados.
- max-snippet, max-image-preview e max-video-preview: limitam aspectos do trecho ou da prévia de mídia exibidos.
- data-nosnippet: pode excluir trechos específicos do texto de um snippet e é aplicado a elementos HTML compatíveis.
- indexifembedded: em combinação com noindex, permite ao Google considerar o conteúdo quando ele é incorporado em outra página; é um caso específico, não uma diretiva geral de indexação.
As regras controlam aspectos diferentes e podem ser combinadas. Consulte a documentação atual antes de usar diretivas pouco comuns; o suporte pode variar entre mecanismos de busca.
Especificações de meta robots, data-nosnippet e X-Robots-Tag — Google Search Central
Quando usar X-Robots-Tag
O cabeçalho HTTP X-Robots-Tag permite aplicar regras a respostas do servidor. Ele é útil para arquivos que não têm um head HTML, como PDFs, imagens e outros recursos. Para uma página HTML, a meta robots costuma ser mais simples de conferir no código renderizado; escolha a forma que se encaixa na infraestrutura e evite configurar instruções contraditórias.
Como aplicar no WordPress com cuidado
- Confirme se a página deve permanecer disponível em busca antes de escolher noindex.
- Confira as configurações de visibilidade do WordPress e do plugin de SEO ativo.
- Defina a regra em um único lugar sempre que possível; verifique se outro plugin ou tema não injeta uma segunda meta robots.
- Revise o código final da página, incluindo o conteúdo do head, depois de salvar.
- Confira se o robots.txt permite que o Google rastreie a URL para ler a instrução.
- Teste a URL no Search Console e registre a mudança e o motivo no controle técnico do site.
A localização do controle no painel muda conforme o plugin e a versão do WordPress. Evite seguir um caminho de menu antigo sem confirmar qual ferramenta está ativa no site.
Como verificar se a diretiva está funcionando
- Inspecione a URL no Search Console e observe o estado conhecido pelo Google.
- Use o teste da URL publicada para verificar a página que o Google consegue acessar agora.
- Confira se a meta robots ou o cabeçalho HTTP está presente na resposta final, e não apenas no editor.
- Confirme se o robots.txt não bloqueia a URL que precisa ser rastreada para receber o noindex.
- Após corrigir uma configuração, aguarde novo rastreamento; uma solicitação de indexação não garante prazo nem inclusão.
Como usar o Search Console — Google Search Central
Meta robots não substitui canonical nem redirecionamento
Canonical informa qual URL deve ser tratada como principal entre versões duplicadas ou muito semelhantes; noindex pede que uma URL não apareça nos resultados. Um redirecionamento conduz usuários e rastreadores de um endereço para outro. Escolha a solução conforme o estado real da página, sem usar noindex como substituto automático para consolidar duplicatas ou retirar uma URL permanentemente.
Erros que podem esconder páginas importantes
- Deixar noindex ativo depois de publicar uma página que deveria participar da busca.
- Bloquear a URL no robots.txt e esperar que o Google leia o noindex.
- Aplicar regras opostas em plugin, tema, servidor ou cabeçalhos.
- Usar noindex para tentar forçar o Google a escolher outra canonical.
- Acreditar que index ou follow garantem inclusão e tratamento específico nos resultados.
- Verificar apenas a configuração no painel e não a resposta final entregue ao rastreador.
Checklist de revisão final
Antes de publicar ou atualizar o artigo, confirme estes pontos:
- A intenção da página e o público estão definidos e refletem uma necessidade real.
- Afirmações, números, condições e exemplos foram validados com fontes ou responsáveis competentes.
- Título, descrição, URL, links e imagem representam o conteúdo publicado com clareza.
- Leitura, navegação e ações principais funcionam em dispositivos móveis e com teclado.
- Há uma pessoa responsável e uma data de revisão para manter o artigo atualizado.
Perguntas frequentes sobre meta robots
noindex remove uma página do Google imediatamente?
Não. O Google precisa rastrear a página e processar a diretiva. A remoção pode levar tempo, e uma solicitação no Search Console não garante um prazo exato.
Posso bloquear no robots.txt e usar noindex ao mesmo tempo?
Se o Google não puder rastrear a URL, ele não conseguirá ler o noindex. Quando a intenção é impedir a indexação, permita o acesso do rastreador à página para que ele veja a regra.
A diretiva index garante que a página será indexada?
Não. Index é o comportamento padrão e não obriga o Google a indexar uma página. A inclusão depende da avaliação do mecanismo e de outros fatores técnicos e de qualidade.
Revise as diretivas antes de publicar ou migrar páginas
Uma regra de indexação deve refletir uma decisão consciente sobre cada página ou grupo de URLs. Ao revisar o site, confira a resposta final, o robots.txt e o estado da URL no Search Console; essa checagem simples reduz o risco de esconder páginas relevantes ou deixar conteúdo de teste aberto à busca.