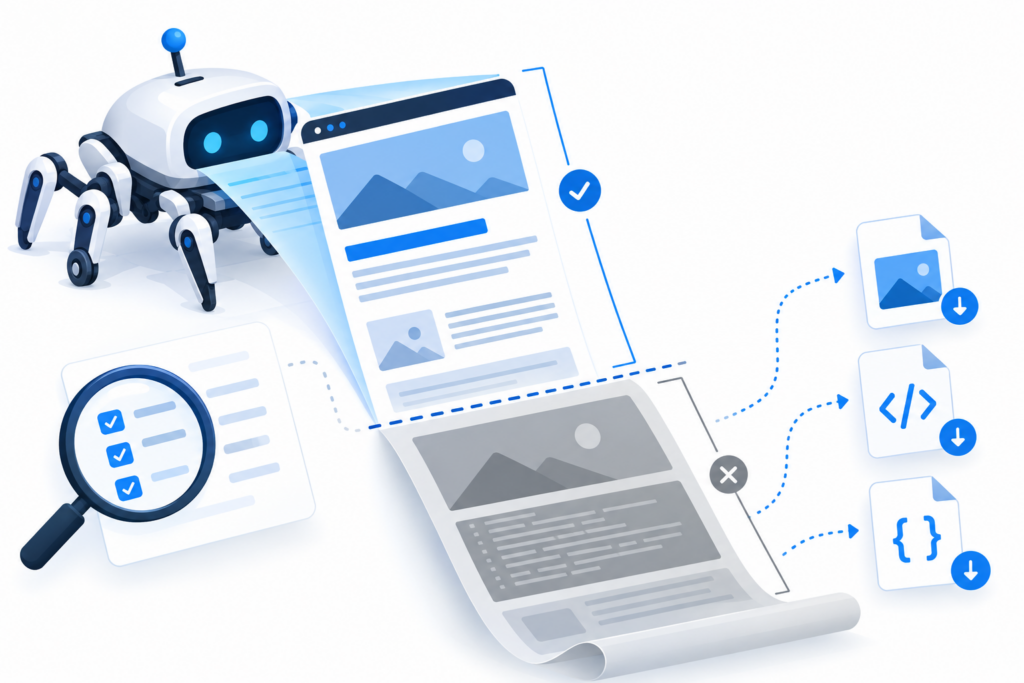
O Googlebot busca até 2 MB por URL para a maioria dos tipos de arquivo compatíveis com a Pesquisa Google. Para PDFs, o limite documentado é 64 MB. Se o arquivo HTML ultrapassar o limite, o Googlebot interrompe a busca; não rejeita automaticamente a página inteira.
O detalhe importante é que os 2 MB se referem ao arquivo buscado naquela URL, não à soma de tudo o que o navegador carrega para mostrar uma página. Imagens, folhas de estilo e scripts referenciados no HTML são solicitados separadamente e têm contadores próprios.
Como funciona o limite de bytes
Segundo a documentação atual do Google, o limite de tamanho é aplicado aos dados não compactados. No caso do Googlebot da Pesquisa, os primeiros 2 MB de um arquivo compatível são considerados, incluindo o cabeçalho HTTP. A documentação estabelece um limite de 64 MB para arquivos PDF.
- Até o limite, o conteúdo baixado pode seguir para os sistemas de indexação e renderização.
- Os bytes que ficam depois do corte não são buscados, renderizados nem considerados para indexação.
- Cada recurso externo tem uma busca separada e não consome o limite do documento HTML principal.
- Outros rastreadores do Google podem ter limites diferentes; não aplique o valor do Googlebot a todos os produtos.
Documentação oficial: limites de arquivo e funcionamento do Googlebot
Explicação do Google sobre bytes, corte e recursos separados
2 MB não é o peso total da página
Uma página pode somar muitos megabytes quando se juntam imagens, fontes, scripts e outros recursos. Essa soma do carregamento não é o mesmo que o tamanho do arquivo HTML inicial. Para avaliar o limite do Googlebot, é necessário identificar a resposta HTML daquela URL e analisar os bytes dela.
Exemplo de aplicação
Uma imagem referenciada por menor quecodemaior quesrcmenor que/codemaior que, por exemplo, costuma ser buscada em outro endereço. Já uma imagem codificada como base64 dentro do HTML ocupa espaço no próprio documento e aumenta o tamanho da resposta principal. O mesmo vale para grandes blocos de CSS, JavaScript ou dados embutidos.
O que pode ficar depois do corte
Se um documento muito grande tiver navegação, componentes ou dados embutidos antes do conteúdo principal, partes importantes podem ficar além do limite. Isso pode incluir texto, links, canonical, metadados ou dados estruturados posicionados tarde no HTML. O risco depende da resposta real do servidor, não apenas da aparência visual no navegador.
A documentação do Google descreve o cenário como uma busca parcial: o arquivo não é recusado por exceder 2 MB, mas os bytes posteriores ao limite não chegam ao processo de renderização e indexação. Isso é diferente de uma penalidade ou de um aviso automático no Search Console.
Como verificar uma página com HTML grande
1. Analise o documento principal, não a soma dos recursos
Escolha uma URL representativa e identifique a solicitação cujo tipo é o documento HTML principal. Separe essa resposta dos arquivos de imagem, JavaScript, CSS e fontes mostrados na aba de rede do navegador. Uma coluna de tamanho agregado da página não responde sozinha à pergunta sobre o limite do Googlebot.
2. Confira os bytes não compactados da resposta
Meça o arquivo HTML descompactado recebido para aquela URL. Uma conexão pode transmitir conteúdo comprimido, mas a referência da documentação para o limite é o tamanho não compactado. Se a ferramenta mostrar tamanhos transferidos e tamanhos de recurso, confira qual deles corresponde ao conteúdo descomprimido.
3. Localize o que ocupa o início do HTML
Procure imagens base64, grandes blocos de estilo ou script inline, menus repetidos e dados embutidos sem necessidade. Confira também em que posição aparecem o título, a canonical, os links principais, o conteúdo que responde à busca e a marcação estruturada que descreve a página.
4. Reduza duplicações e mantenha o essencial cedo
Quando houver excesso comprovado, avalie mover código e estilos para arquivos externos, referenciar imagens como arquivos próprios e evitar repetir grandes blocos de marcação em cada URL. Posicione elementos importantes no início do documento, mantendo o conteúdo semântico completo e acessível.
5. Confira a renderização e as páginas importantes
Use a inspeção de URL do Search Console para verificar a versão testada, o conteúdo renderizado e os sinais de indexação disponíveis. O relatório não é um contador específico de bytes cortados; compare a resposta de origem com a renderização e revise as URLs com estruturas mais pesadas.
Os registros do servidor podem ajudar a localizar solicitações do Googlebot, o código de resposta e o volume servido, mas não mostram por si sós todo o conteúdo que os sistemas de indexação aproveitaram. Se precisar confirmar a origem de uma requisição, valide o rastreador pelas faixas de IP ou pelo procedimento de DNS reverso do Google.
Como verificar e identificar acessos do Googlebot
Quando vale priorizar essa revisão
Para a maioria dos sites, 2 MB de HTML é um limite alto e não exige uma otimização preventiva em todas as páginas. Investigue quando a resposta HTML é incomumente grande, quando a página depende de muito conteúdo inline ou quando há motivo para suspeitar que elementos essenciais aparecem apenas perto do fim do documento.
O peso total de uma homepage em um estudo de desempenho não prova que seu HTML ultrapassou o limite. Esses estudos podem somar recursos separados, enquanto a regra do Googlebot se aplica a cada URL buscada. Trate o limite como uma verificação técnica para casos reais, sem converter o número em fator de ranking isolado.
Checklist de revisão final
Antes de publicar ou atualizar o artigo, confirme estes pontos:
- A intenção da página e o público estão definidos e refletem uma necessidade real.
- Afirmações, números, condições e exemplos foram validados com fontes ou responsáveis competentes.
- Título, descrição, URL, links e imagem representam o conteúdo publicado com clareza.
- Leitura, navegação e ações principais funcionam em dispositivos móveis e com teclado.
- Há uma pessoa responsável e uma data de revisão para manter o artigo atualizado.
Perguntas frequentes
O Googlebot deixa de indexar uma página inteira ao passar de 2 MB? Não necessariamente. Ele interrompe a busca no limite e encaminha a parte obtida para consideração. O conteúdo que ficou depois do corte não é buscado, renderizado nem indexado.
Os 2 MB incluem imagens, CSS e JavaScript externos? Não. Arquivos referenciados são buscados separadamente e possuem contadores próprios. Imagens ou código incorporados diretamente no HTML, como data URIs e blocos inline, fazem parte do arquivo principal.
O limite é medido com o arquivo comprimido? A documentação do Google diz que o tamanho é aplicado aos dados não compactados. Por isso, não use a quantidade transferida após compressão como única medida.
Qual é o limite para PDFs? A documentação atual informa que o Googlebot da Pesquisa busca os primeiros 64 MB de um PDF.
Toda página precisa ficar abaixo de 2 MB para ranquear? O tamanho não deve ser tratado como meta universal ou fator isolado de classificação. O cuidado prático é garantir que as partes importantes do documento possam ser obtidas e interpretadas.
O limite pode mudar? Sim. O Google informa que os limites podem ser atualizados. Confirme a documentação oficial antes de usar o número em uma auditoria futura.
A revisão certa separa o documento HTML dos recursos carregados à parte, mede a resposta não compactada e confirma a posição dos elementos importantes. Só depois de encontrar um excesso concreto vale simplificar o HTML; o número de 2 MB, sozinho, não indica um problema no site.